(Book) Networking with MikroTik RouterOS: A Practical Approach to Understanding and Implementing RouterOS
Study material for the MTCNA Certification Course, updated to RouterOS v7
$19,97
Cuando hablamos de alta disponibilidad en redes, hay una pregunta que aparece tarde o temprano: ¿qué ocurre si el router que funciona como gateway deja de responder?
En una red pequeña quizá tengamos un único router y el problema sea evidente: si ese equipo falla, los dispositivos pueden seguir funcionando entre ellos dentro de la LAN, pero perderán la salida hacia otras redes. En una infraestructura empresarial, sin embargo, depender de un único gateway puede convertirse en un punto único de fallo.
Aquí es donde entran HSRP, VRRP y GLBP, tres protocolos de First Hop Redundancy Protocol (FHRP) diseñados para proporcionar redundancia en el primer salto de una red. Su objetivo principal es que los equipos de la LAN puedan utilizar un gateway virtual sin tener que conocer cuál de los routers físicos está atendiendo realmente el tráfico.
Aunque los tres persiguen objetivos relacionados, no son exactamente iguales. HSRP y GLBP están asociados al ecosistema Cisco, mientras que VRRP está definido mediante estándares de la IETF y resulta especialmente interesante cuando trabajamos con equipos de distintos fabricantes. GLBP, además, introduce una característica que cambia bastante el planteamiento: el balanceo de carga entre múltiples gateways.
Y hay una aclaración importante que conviene hacer desde el principio: tener redundancia de gateway no significa automáticamente tener redundancia de Internet o del proveedor. Son problemas diferentes y requieren diseños diferentes.
Al final del artículo encontrarás un pequeño test que te permitirá evaluar los conocimientos adquiridos en esta lectura
Imaginemos una LAN con varios ordenadores, servidores, teléfonos IP y otros dispositivos. Todos necesitan comunicarse con redes que están fuera de su propia subred, así que utilizan un gateway predeterminado.
Podríamos tener una topología sencilla:
             Internet / WAN
                   |
                Router 1
                   |
                   |
              Switch LAN
             /    |    \
          PC1    PC2   Servidor
Mientras Router 1 funciona, no hay demasiado misterio. Los dispositivos utilizan su dirección IP como gateway y el tráfico sale por él.
El problema aparece cuando Router 1 falla.
El PC no sabe automáticamente que existe otro router disponible. Para el host, su gateway sigue siendo la dirección configurada en la tarjeta de red. Si esa dirección deja de estar disponible, tendremos un problema aunque tengamos un segundo router físicamente conectado a la misma red.
La idea de los FHRP es precisamente solucionar este punto único de fallo. En lugar de hacer que los hosts dependan directamente de la dirección física de un router, varios routers pueden participar en un router lógico o gateway virtual. Los hosts utilizan esa dirección virtual como puerta de enlace y los routers se encargan de decidir cuál está atendiendo el tráfico.
Sin redundancia podríamos tener:
PCs
 |
 | Gateway 192.168.10.1
 |
Router 1
 |
WAN
Si Router 1 desaparece, desaparece también el gateway.
Con un protocolo de redundancia podemos plantear algo así:
                    Gateway virtual
                    192.168.10.1
                         |
                +--------+--------+
                |                 |
             Router 1          Router 2
             Master/Active      Backup
                |                 |
                +--------+--------+
                         |
                       LAN
Los hosts continúan utilizando 192.168.10.1 como gateway. No necesitan cambiar su configuración cuando el router activo deja de estar disponible.
En VRRP, por ejemplo, los routers forman un grupo lógico denominado Virtual Router. Existe un router Master y uno o más Backup, y la elección está basada en prioridades.
FHRP significa First Hop Redundancy Protocol.
La expresión “primer salto” tiene bastante sentido: hablamos del primer router al que llega el tráfico de un host cuando necesita abandonar su red local.
HSRP, VRRP y GLBP solucionan principalmente esa redundancia del gateway. No sustituyen a protocolos de routing como OSPF o BGP, ni convierten por sí mismos dos conexiones de Internet en una única conexión redundante.
Esta diferencia es fundamental.
Puedes tener:
y aun así tener un único enlace hacia el proveedor.
En ese caso has eliminado un punto único de fallo dentro de tu infraestructura, pero todavía tienes otro punto único de fallo en la salida WAN.
HSRP (Hot Standby Router Protocol) es el protocolo de redundancia de primer salto desarrollado por Cisco.
Su funcionamiento básico es sencillo: varios dispositivos participan en un grupo HSRP y presentan ante los hosts la apariencia de un único router virtual. Dentro del grupo, un router asume el papel de Active y otro puede permanecer como Standby preparado para asumir el servicio si el activo falla.
En una implementación típica podríamos tener:
             IP virtual
             192.168.1.1
                   |
          +--------+--------+
          |                 |
       Router A          Router B
        ACTIVE           STANDBY
          |                 |
          +--------+--------+
                   |
                Switch
                   |
                 Hosts
Los hosts no necesitan utilizar directamente la IP física de Router A.
Utilizan la IP virtual.
Mientras Router A está operativo, es el Active Router y se encarga de reenviar el tráfico destinado al gateway virtual. Router B permanece preparado para asumir el papel de Active si detecta que el router principal ha fallado. Cisco describe precisamente este mecanismo como una forma de presentar un router virtual o gateway predeterminado único a los hosts de una LAN.
El protocolo utiliza mensajes Hello para que los routers conozcan el estado de los miembros del grupo. Si el Active deja de funcionar, el Standby puede asumir sus funciones.
La prioridad es uno de los elementos importantes de HSRP. En la documentación de Cisco, una prioridad mayor hace que un router tenga mayor posibilidad de convertirse en Active, especialmente cuando se utiliza preemption. La prioridad predeterminada indicada para HSRP en la documentación consultada es 100.
También es posible realizar tracking de interfaces. Esto resulta especialmente útil porque un router puede seguir encendido aunque haya perdido una interfaz importante.
Por ejemplo:
Router A
 |
 +--- LAN       OK
 |
 +--- WAN       FALLA
Si únicamente comprobamos si Router A está encendido, podríamos concluir que todo está bien. Pero desde el punto de vista de los usuarios, quizá Router A ya no sea el mejor gateway.
El tracking permite asociar determinadas condiciones de la infraestructura con la prioridad del router. Cisco documenta este mecanismo para que una caída de una interfaz monitorizada pueda reducir la prioridad HSRP y facilitar que otro router asuma el papel activo.
Esto nos lleva a una idea importante: la alta disponibilidad no consiste simplemente en poner dos routers juntos. Hay que definir qué significa realmente que un router esté “disponible”.
Un equipo puede estar encendido y, sin embargo, no tener conectividad hacia el destino que nos interesa.
HSRP tiene mucho sentido cuando la infraestructura está basada principalmente en Cisco y queremos mantener una arquitectura de redundancia integrada con ese ecosistema.
También permite construir diseños más elaborados. Por ejemplo, Cisco documenta Multiple HSRP (MHSRP), mediante el cual se pueden utilizar varios grupos HSRP para distribuir tráfico entre routers. En ese escenario, un router puede ser Active para un grupo y el otro Active para un segundo grupo, permitiendo compartir carga sin que eso convierta a HSRP en un protocolo de balanceo equivalente a GLBP.
En otras palabras, HSRP puede utilizarse para diseñar redundancia y determinados esquemas de distribución, pero su modelo fundamental sigue siendo el de Active/Standby.
VRRP (Virtual Router Redundancy Protocol) persigue el mismo objetivo general: evitar que un único router sea el punto de fallo del gateway.
La diferencia más conocida frente a HSRP es que VRRP está definido por la IETF mediante RFC. RouterOS, por ejemplo, documenta soporte para VRRPv2 basado en RFC 3768 y VRRPv3 basado en RFC 5798.
Esto es importante cuando tenemos una infraestructura heterogénea.
Si una organización utiliza equipos de diferentes fabricantes, disponer de un protocolo estandarizado puede resultar mucho más conveniente que depender de una implementación propietaria.
El modelo conceptual es parecido al de HSRP, aunque cambian los nombres:
                 IP virtual
                 192.168.10.1
                       |
              +--------+--------+
              |                 |
           Router 1          Router 2
            MASTER            BACKUP
              |                 |
              +--------+--------+
                       |
                     LAN
El Master es quien está reenviando el tráfico correspondiente al router virtual.
Los Backup permanecen atentos a los anuncios VRRP. Si el Master deja de estar disponible, uno de los Backup puede convertirse en Master según las reglas de prioridad y preemption.
VRRP utiliza el protocolo IP número 112 y, en IPv4, los mensajes se envían mediante multicast a 224.0.0.18. Los paquetes VRRP utilizan TTL 255 y no deben ser reenviados por routers.
Estos detalles quizá no sean necesarios para configurar una red pequeña, pero sí son útiles para entender por qué VRRP debe funcionar correctamente en el segmento donde participan los routers.
Un concepto fundamental en VRRP es el VRID (Virtual Router ID).
El VRID identifica el router virtual. Los dispositivos que participan en el mismo router virtual deben utilizar la configuración correspondiente para formar parte del mismo grupo.
Además, todos los miembros utilizan la misma dirección IP virtual. Los hosts de la LAN utilizan esa dirección como gateway.
RouterOS documenta también una dirección MAC virtual asociada al VRID. El Master responde a las solicitudes ARP correspondientes a la IP virtual, mientras que los Backup no responden a esas solicitudes mientras permanecen en estado Backup.
Cuando el Backup pasa a Master, RouterOS puede enviar un gratuitous ARP en IPv4 para ayudar a actualizar la información de los dispositivos de la red.
Desde el punto de vista del usuario final, lo importante es que la dirección de gateway no cambia.
Ese es precisamente uno de los grandes beneficios de este tipo de protocolos.
Aquí es donde puedo hablar desde una experiencia más directa: en mi caso, el protocolo que he utilizado es VRRP en MikroTik.
Y precisamente por trabajar con VRRP en MikroTik, hay algo que considero importante no perder de vista: VRRP no es simplemente “poner otra IP al segundo router”. La idea es construir un gateway virtual que pueda cambiar de dispositivo cuando las condiciones lo requieran.
La documentación actual de RouterOS muestra un escenario básico en el que se crea una interfaz VRRP sobre una interfaz física y se asigna la dirección virtual al interfaz VRRP. También contempla estados Init, Backup y Master, además de prioridades y preemption.
Un esquema conceptual sería:
                   192.168.10.1
                   Gateway virtual
                         |
               +---------+---------+
               |                   |
          MikroTik R1         MikroTik R2
           PRIORIDAD 150       PRIORIDAD 100
             MASTER              BACKUP
               |                   |
               +---------+---------+
                         |
                       LAN
Si R1 deja de estar disponible, R2 puede asumir el gateway virtual.
Esto permite que los hosts sigan utilizando:
Gateway: 192.168.10.1sin tener que cambiar su configuración.
RouterOS también contempla sincronización de connection tracking entre dispositivos VRRP en determinadas configuraciones. Esto puede ser relevante cuando los routers realizan funciones de firewall/NAT y queremos reducir el impacto de un failover.
GLBP (Gateway Load Balancing Protocol) también fue desarrollado por Cisco, pero introduce una diferencia importante frente al modelo tradicional de HSRP y VRRP: además de proporcionar redundancia, permite distribuir el tráfico entre múltiples routers.
En HSRP o VRRP podemos tener dos routers, pero normalmente uno está reenviando tráfico mientras el otro está preparado para tomar el control.
GLBP intenta aprovechar los recursos de los dos routers simultáneamente.
GLBP introduce diferentes roles, entre ellos:
El AVG desempeña una función de control dentro del grupo y participa en la gestión de las direcciones virtuales. Los AVF son los routers que realmente pueden reenviar tráfico.
La idea puede visualizarse así:
                    Gateway virtual
                          |
                +---------+---------+
                |         |         |
             Router 1  Router 2  Router 3
                |         |         |
               AVF       AVF       AVF
                \         |         /
                 \        |        /
                    Tráfico LAN
Esto es diferente del modelo clásico:
Router A = trabaja
Router B = espera
En GLBP, varios routers pueden participar activamente en el forwarding.
Aquí está la principal característica diferenciadora de GLBP.
Cisco documenta que GLBP proporciona redundancia y además balanceo de carga utilizando una única IP virtual y múltiples direcciones MAC virtuales.
GeeksforGeeks también identifica esta característica como una de las diferencias principales frente a HSRP y VRRP.
Esto puede ser interesante cuando tenemos varios routers con capacidad suficiente y queremos aprovecharlos durante el funcionamiento normal, en lugar de mantener uno prácticamente inactivo esperando un fallo.
GLBP puede utilizar distintos métodos de distribución de carga. La documentación comparativa consultada menciona esquemas como Round-Robin, Weighted y Host-Dependent.
La ventaja es clara: no solo pensamos en qué hacer cuando un router falla, sino también en cómo aprovechar los recursos disponibles cuando todo funciona correctamente.
Eso sí, la mayor complejidad también debe considerarse. No siempre necesitamos balanceo de gateway. En una red sencilla, introducir una solución más compleja solo porque “es más avanzada” puede terminar complicando innecesariamente la operación y el troubleshooting.
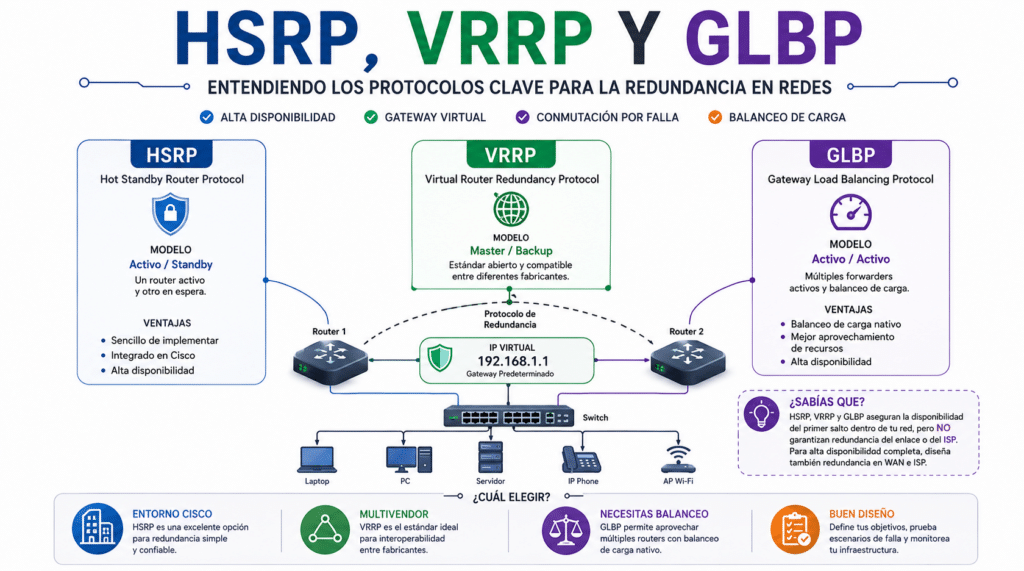
La comparación más útil no consiste en memorizar siglas, sino en entender qué problema resuelve cada protocolo y qué restricciones tiene.
| Característica | HSRP | VRRP | GLBP |
|---|---|---|---|
| Tipo | FHRP | FHRP | FHRP |
| Ecosistema principal | Cisco | Multivendor | Cisco |
| Estándar | Propietario | IETF | Propietario |
| Gateway virtual | Sí | Sí | Sí |
| Redundancia | Sí | Sí | Sí |
| Balanceo integrado | No | No | Sí |
| Modelo habitual | Active/Standby | Master/Backup | AVG/AVF |
| Uso típico | Redes Cisco | Redes heterogéneas | Redes Cisco con necesidad de balanceo |
La documentación de Cisco confirma que HSRP ofrece redundancia del primer salto y que GLBP añade balanceo de carga mediante múltiples MAC virtuales. La documentación de MikroTik, por su parte, implementa VRRP conforme a RFC 3768/RFC 5798.
Una de las diferencias que más peso puede tener en un proyecto es el ecosistema.
HSRP y GLBP están vinculados al ecosistema Cisco. VRRP, en cambio, está definido por la IETF.
Por eso VRRP suele resultar especialmente atractivo en escenarios donde existen dispositivos de diferentes fabricantes.
Por ejemplo:
        MikroTik
           |
           +------ LAN ------+
                            |
                          Cisco
Si los dos equipos soportan correctamente VRRP, es posible construir un esquema de redundancia utilizando un protocolo común.
Esto no significa que cualquier combinación de fabricantes vaya a comportarse idénticamente en todos los escenarios. Siempre hay que comprobar la implementación concreta, la versión del software y las características soportadas.
Esta es probablemente la diferencia conceptual más sencilla:
HSRP y VRRP buscan principalmente mantener disponible el gateway.
GLBP busca mantenerlo disponible y distribuir tráfico entre varios routers.
Eso no convierte automáticamente a GLBP en “mejor”.
Si solamente necesitamos:
Router A → activo
Router B → respaldo
VRRP o HSRP pueden ser perfectamente suficientes.
Si necesitamos aprovechar simultáneamente varios routers:
Router A → tráfico
Router B → tráfico
Router C → tráfico
GLBP puede resultar más apropiado dentro de un entorno Cisco compatible.
Aquí VRRP tiene una ventaja conceptual importante.
Si tenemos una red basada exclusivamente en Cisco, HSRP puede encajar perfectamente.
Pero si tenemos una mezcla como:
VRRP puede ser una alternativa mucho más natural siempre que todos los equipos involucrados soporten las funciones necesarias.
En mi caso, al haber utilizado VRRP con MikroTik, esta es precisamente una de las razones por las que resulta interesante conocer bien el protocolo: no estamos limitando el concepto de redundancia exclusivamente a un fabricante.
No existe una respuesta universal.
La elección depende del fabricante, del diseño de la red, de la necesidad de balanceo y de qué queremos conseguir exactamente.
HSRP puede ser una opción natural para proporcionar redundancia del gateway.
Además, Cisco ofrece mecanismos complementarios como prioridad, preemption y tracking, que permiten adaptar el comportamiento del failover a las condiciones de la infraestructura.
Si la red ya está construida alrededor de Cisco, utilizar una tecnología integrada con ese ecosistema puede simplificar la operación.
Aquí VRRP suele ser una opción especialmente interesante.
Su estandarización mediante RFC facilita el diseño de una solución de redundancia que no dependa exclusivamente de un fabricante. RouterOS, por ejemplo, implementa VRRPv2 y VRRPv3.
Y esta es una situación bastante real en redes de empresas: no siempre todos los dispositivos son del mismo fabricante.
Podemos tener un firewall de un fabricante, routers de otro y switches de un tercero. En esos escenarios, los estándares abiertos pueden simplificar bastante las decisiones de arquitectura.
Si estamos dentro de un entorno Cisco compatible y queremos utilizar simultáneamente varios routers como gateways activos, GLBP merece consideración.
La característica diferencial es precisamente esa: no se limita a tener un router activo y otro esperando, sino que permite distribuir el tráfico entre múltiples forwarders.
Pero hay que tener claro que redundancia y balanceo son requisitos diferentes.
No tiene sentido introducir GLBP únicamente porque permite balanceo si la red no lo necesita.
Esta es, probablemente, una de las partes más importantes del artículo.
Cuando hablamos de alta disponibilidad, es muy fácil pensar:
“Tengo dos routers con VRRP, por lo tanto mi conexión a Internet es redundante.”
No necesariamente.
VRRP puede solucionar la redundancia del gateway dentro de nuestra infraestructura, pero no hace desaparecer los puntos de fallo que existen fuera de ella.
Supongamos que tenemos:
                  LAN
                   |
          +--------+--------+
          |                 |
       MikroTik 1        MikroTik 2
          |                 |
          +--------+--------+
                   |
              Gateway VRRP
                   |
                ISP
Tenemos dos routers internos.
Si MikroTik 1 falla, MikroTik 2 puede asumir el gateway virtual.
Eso es redundancia del primer salto.
Pero ahora imaginemos:
MikroTik 1 ----+
               |
               +---- Router/CPE ISP ---- Internet
               |
MikroTik 2 ----+
Si existe un único equipo del proveedor y ese equipo falla, VRRP no puede reemplazarlo mágicamente.
Tampoco puede reparar un único circuito de fibra, un único radioenlace o una única conexión física hacia el operador.
Aquí debemos separar dos escenarios.
Escenario 1: falla un router interno.
VRRP puede ayudar:
Router A ❌
     |
Router B ✅
     |
Internet
Si Router B conserva una ruta funcional hacia Internet, los usuarios pueden continuar utilizando el servicio.
Escenario 2: falla el único camino hacia el proveedor.
Tenemos:
Router A ✅
Router B ✅
     |
     X
     |
   ISP ❌
Los dos routers pueden estar perfectamente operativos y VRRP puede seguir funcionando, pero la salida hacia el proveedor no existe.
Por eso, cuando hablamos de alta disponibilidad de verdad, hay que preguntarse:
¿Qué componentes quiero hacer redundantes?
Puede ser:
Cada capa requiere mecanismos diferentes.
Esta distinción merece quedar grabada:
VRRP, HSRP y GLBP solucionan principalmente la redundancia del primer salto; no garantizan por sí solos la disponibilidad del servicio del ISP.
En mi experiencia con VRRP en MikroTik, precisamente considero importante tener esto en cuenta: la alta disponibilidad que estamos implementando debe entenderse dentro del ámbito de la red que controlamos.
Si queremos redundancia frente al proveedor, debemos diseñar también esa parte.
Por ejemplo, podríamos plantear:
                    Internet
                   /        \
                ISP 1      ISP 2
                  |          |
               Router 1   Router 2
                  \          /
                   \        /
                    LAN
A partir de ahí aparecen otras tecnologías y estrategias de routing, failover y multihoming que ya pertenecen a otro nivel del diseño.
La clave es no confundirlas con FHRP.
Un escenario sencillo puede ser el siguiente:
                    LAN
                     |
             +-------+-------+
             |               |
         MikroTik R1     MikroTik R2
         192.168.10.2    192.168.10.3
             |               |
             +-------+-------+
                     |
             VRRP: 192.168.10.1
                     |
                  Clientes
Los clientes utilizan:
IP:       192.168.10.x
Gateway:  192.168.10.1
La dirección 192.168.10.1 es el gateway virtual.
R1 podría tener una prioridad superior a R2:
R1 → prioridad 150
R2 → prioridad 100
En condiciones normales, R1 actuaría como Master y R2 como Backup.
Si R1 deja de estar disponible, R2 puede asumir el estado Master.
La documentación de RouterOS explica precisamente este comportamiento: el Master funciona como gateway físico del router virtual y, cuando deja de estar disponible, un Backup puede asumir el papel de Master según la prioridad configurada.
La ventaja para los clientes es que su configuración no necesita cambiar.
No tenemos:
Antes:
Gateway = 192.168.10.2

Después del fallo:
Gateway = 192.168.10.3
Tenemos:
Siempre:
Gateway = 192.168.10.1
Lo que cambia internamente es qué dispositivo está respondiendo por esa dirección virtual.
Esta abstracción es justamente lo que hace tan útil a VRRP.
RouterOS también utiliza una MAC virtual asociada al router virtual. Cuando un dispositivo pasa a Master, puede anunciar el cambio mediante mecanismos como gratuitous ARP en IPv4 para facilitar la actualización de las tablas ARP de los equipos de la red.
El proceso, simplificado, sería:
RouterOS documenta estados Init, Backup y Master y explica cómo el Backup puede pasar a Master cuando deja de recibir correctamente los anuncios del Master.
En un entorno real, sin embargo, no deberíamos quedarnos únicamente con el ejemplo de “se apagó el router”.
También debemos preguntarnos:
¿Qué ocurre si el router está encendido pero perdió su salida WAN?
Ese caso es mucho más interesante desde el punto de vista del diseño.
Porque si el router sigue anunciándose como Master aunque ya no pueda proporcionar conectividad útil, podemos terminar enviando tráfico hacia un dispositivo que técnicamente está “vivo”, pero que no puede llevar los paquetes a su destino.
Por eso la monitorización, el tracking y el diseño de las rutas son tan importantes como el propio FHRP.
Antes de implementar VRRP en MikroTik conviene revisar al menos:
RouterOS recomienda utilizar la misma versión de RouterOS en los dispositivos que compartan un mismo VRID y documenta además consideraciones específicas sobre intervalos de anuncios, direcciones virtuales y sincronización de connection tracking.
No debemos olvidar que VRRP no sustituye el diseño de routing.
Es perfectamente posible tener VRRP funcionando y, aun así, tener una configuración de rutas incorrecta.
Uno de los errores más frecuentes es pensar que tener dos routers conectados significa automáticamente tener alta disponibilidad.
No es así.
La alta disponibilidad debe analizarse desde el punto de vista del servicio.
Dos routers ayudan a eliminar un punto de fallo, pero quizá exista otro:
Router 1 ──┐
           ├── Switch único ── ISP
Router 2 ──┘
Si el switch falla, ambos routers dejan de ser accesibles.
Si el enlace hacia el ISP falla, ambos routers pueden quedarse sin salida.
Hay que analizar toda la cadena.
VRRP está pensado fundamentalmente para redundancia del gateway.
No debemos asumir que porque tenemos dos routers participando en VRRP automáticamente estamos utilizando ambos para repartir el tráfico.
La comparación de GeeksforGeeks diferencia precisamente VRRP y HSRP de GLBP en este aspecto: GLBP incorpora mecanismos de balanceo de carga entre routers.
Una configuración que “se ve bien” no significa que esté probada.
Hay que comprobar escenarios como:
La prueba real es la que nos dice si la alta disponibilidad funciona como esperamos.
Preemption determina, según el protocolo y la configuración, qué sucede cuando vuelve a aparecer un router con mayor prioridad.
Podemos querer que vuelva a convertirse en Master/Active.
O quizá prefiramos que el router que actualmente está prestando servicio continúe haciéndolo.
No hay una respuesta universal: depende del diseño.
Lo importante es decidirlo conscientemente.
HSRP, VRRP y GLBP no son sustitutos de un protocolo de routing.
Su función es proporcionar redundancia en el primer salto.
Podemos tener una red donde coexistieran:
VRRP → redundancia del gateway
OSPF → routing interno
BGP → intercambio de rutas con proveedores
Cada tecnología estaría resolviendo un problema diferente.
HSRP, VRRP y GLBP pertenecen a la familia de protocolos FHRP y buscan solucionar uno de los problemas clásicos de las redes IP: evitar que el gateway predeterminado sea un punto único de fallo.
HSRP es una opción muy asociada a entornos Cisco y utiliza el modelo Active/Standby. VRRP ofrece un mecanismo estandarizado para construir un router virtual mediante roles como Master y Backup, lo que lo hace especialmente interesante en redes con equipos de diferentes fabricantes. GLBP añade una característica diferenciadora: balanceo de carga entre múltiples routers, además de la redundancia.
Si tuviera que resumir la elección de una manera sencilla:
Pero hay una idea que considero todavía más importante:
la redundancia del gateway no equivale a la redundancia del proveedor.
Puedes tener dos MikroTik funcionando con VRRP, un gateway virtual perfectamente configurado y un failover correcto, pero si ambos dependen de un único equipo o circuito del ISP, ese elemento sigue siendo un punto único de fallo.
Por eso, cuando diseñemos una red de alta disponibilidad, no deberíamos preguntarnos únicamente:
“¿Tengo dos routers?”
La pregunta correcta es:
“¿Qué ocurre con el servicio si falla cada uno de los componentes que participan en el camino?”
Ahí es donde HSRP, VRRP y GLBP dejan de ser simplemente tres siglas que hay que memorizar y empiezan a convertirse en herramientas reales de diseño de redes.
Son protocolos FHRP utilizados principalmente para proporcionar redundancia del gateway predeterminado en una LAN. Permiten que varios routers participen en un gateway virtual para evitar depender de un único router físico.
La principal diferencia está en su origen y ecosistema. HSRP está asociado a Cisco, mientras que VRRP está estandarizado mediante RFC de la IETF y está diseñado para interoperabilidad entre implementaciones compatibles.
Sí. RouterOS incluye soporte para VRRP y documenta implementaciones basadas en VRRPv2 y VRRPv3.
No de la misma manera que GLBP. VRRP está orientado principalmente a proporcionar redundancia del router virtual. GLBP añade mecanismos específicos para distribuir tráfico entre múltiples routers.
Un Backup puede asumir el papel de Master según las condiciones del protocolo, la prioridad y la configuración de preemption. En ese momento empieza a responder por el router virtual y a reenviar el tráfico correspondiente.
No por sí solo. VRRP puede proporcionar redundancia del gateway dentro de la infraestructura, pero si existe un único enlace, CPE o equipo del proveedor, ese elemento continúa siendo un posible punto único de fallo.
No. Son tecnologías con objetivos diferentes. FHRP proporciona redundancia del primer salto; OSPF es un protocolo de routing utilizado para intercambiar rutas dentro de una infraestructura.
Depende del diseño. En un entorno Cisco, HSRP puede ser una elección natural. En una red multivendor, VRRP puede ser más conveniente. Si necesitamos balanceo de gateway entre varios routers dentro de un entorno compatible, GLBP puede ser una alternativa interesante.
Study material for the MTCNA Certification Course, updated to RouterOS v7
Material de estudio para el Curso de Certificación MTCNA, actualizado a RouterOS v7
En línea
ASISTENTE